 Posted by
前陣子看到 crystl 的 tmux for AI Coding Agents,介紹怎麼用 tmux 同時跑幾個 coding agent。從開 session、送指令、讀畫面,一路談到 agent 變多之後,怎麼知道誰在工作、誰在等你。我現在也在處理類似的事情,只是用的是 Hermes Agent(下文簡稱 Hermes)和 Orca。
這裡會提到 harness 這個詞,可以先把它理解成讓 AI 模型實際工作的那層軟體:替模型接上工具、管理對話與執行過程,讓它能讀檔案、跑指令,接著根據結果繼續做事。
- Hermes 是一種 agent harness,不過它的重點放在自我進化與 orchestration(任務協調)。這裡的自我進化,是把工作中學到的做法整理成可重用的 skills,配合記憶,在之後的工作中使用,不是重新訓練模型。它也能讀寫程式,但我主要用它持續討論需求、分派工作,以及接回其他 agent 的結果。
- Orca 是管理開發工作空間與 agent 的工具。這篇會用到它的工作空間、終端機和任務通訊功能。
- Coding agent 在這篇指的是 Claude Code、Codex CLI(下文簡稱 Codex)、Grok Build 這類以寫程式為主要用途的 harness。它們把模型接到專案檔案、終端機與開發工具上,可以接下一段需求,在指定目錄裡讀程式、修改檔案、執行測試,再根據結果修正。
- 還有一個非常重要的:Issue Tracking System(ITS,議題追蹤系統)。除了讓 agent 知道哪些事情正在做、哪些已經做完,它也承擔了一部分專案長期記憶的工作。以前做過什麼、當時的 spec(規格)長怎樣、為什麼做這個決定,以及實作後跑過哪些測試、結果如何,都可以留在對應的 ticket 裡,或從票上的連結找到。之後換一個 agent 接手,或隔一段時間再回來改同一個功能,就能查回當時的背景,不必只靠某次對話裡的記憶。
它們不是一定要綁在一起用。在我的用法裡,我幾乎不直接找 coding agent,而是跟 Hermes 討論需求,由它透過 Orca 喚起 agent、派工,再接回問題與結果。Orca 則管理這些 agent 所在的工作空間、分支和終端機。需要找回某個任務時,仍然可以回到它原本的地方,但我不必自己逐一開啟 agent、交代背景,再輪流追問進度。
這篇想寫一下我怎麼把它們放在一起用。不是從安裝開始的教學,也沒有一套可以直接複製、適合所有專案的設定。比較像是幾個 agent 一起工作時,我目前怎麼安排事情。
就跟tmux一樣,你總需要一台固定機器來讓你不在時繼續跑
我自己的做法是弄台mac放在家裡面,用tailscale來跟自己筆電放在同一個VPN下。Mac mini 就足以作為起點,不需要為了跑 AI 特別買一台大記憶體的機器。因為我不在這台電腦上跑 local LLM,也就是不把語言模型下載回來做本機推論。模型運算交給 provider(模型服務供應商),透過各工具支援的 API 或訂閱登入方式使用。Mac 上跑的是 Hermes、Orca、coding agent,以及專案本身的開發工具。
換句話說,模型在雲端思考,讀寫檔案、執行指令和測試則在這台 Mac 上進行。它需要穩定的網路,並在工作期間保持開機、不進入睡眠。硬體要留多少餘裕,主要取決於專案建置、測試,以及同時開幾個任務;如果專案本身很吃資源,還是得按實際需求選配。所以這裡說 Mac mini 足夠,指的是不需要先準備一台拿來跑模型的主機。模型服務的費用仍然要付,本機開發與測試需要的資源也不會因此消失。
不過也不是沒有其他替代方案,一台一個月10-15鎂的VPS其實也足夠了,只是很多東西要串起來總不如local有一台電腦方便。
工程師的夢想:放著讓他自動化,但是….
通常我會先跟 Hermes 把幾張票討論到可以派工:規格講清楚、該做的決定做完,再告訴它這一批可以開始。接下來就讓 Hermes orchestrate,由它安排 agent、處理任務之間的先後關係,沒有相依性的工作一起跑。我不需要陪著每個 agent 寫完,也不必等一張票結束才交代下一張,可以先去睡覺。
工作不會停在 agent 寫好程式的那一步。後續開 PR(pull request,也就是提出程式變更供審查)、review 提出問題、交回修正,再檢查新版本,這些來回都可以由 Hermes 協調。UAT(使用者驗收測試)裡能用工具執行的操作與檢查,也可以先自動跑,把結果和還需要人工確認的地方留下來。需要我判斷操作順不順、結果是不是我要的,則整理好入口與待確認事項,等我回來看,不會把 agent 跑過一遍就當作我已經驗收。等我睡醒,回來看的應該是一份整理過的結果:哪些 PR 需要我關注、哪些工作卡在需要我決定的問題,以及哪些 UAT 已經準備好讓我操作。有需要我做的決定,那張票就先停在那裡;不受影響的工作可以繼續。我再根據結果決定要不要部署到 Dev(開發環境)或 Prod(正式環境)。交出去的是這批票的實作與驗證,不是讓系統自行決定上線。
不過這一切都依賴在一個前提,你要知道你的ticket要怎麼ready for implementation?否則接你票的人也做不完,同樣會回來問你,然後工作照樣卡住。把這些工程師無法被取代的工作做完,把流程、工具和授權範圍設定好之後,交給 Hermes 持續協調的工作,不是只裝好兩個工具就會自動發生。下面分開說明這一輪是怎麼接起來的。
我跟 Hermes 討論,由它派工
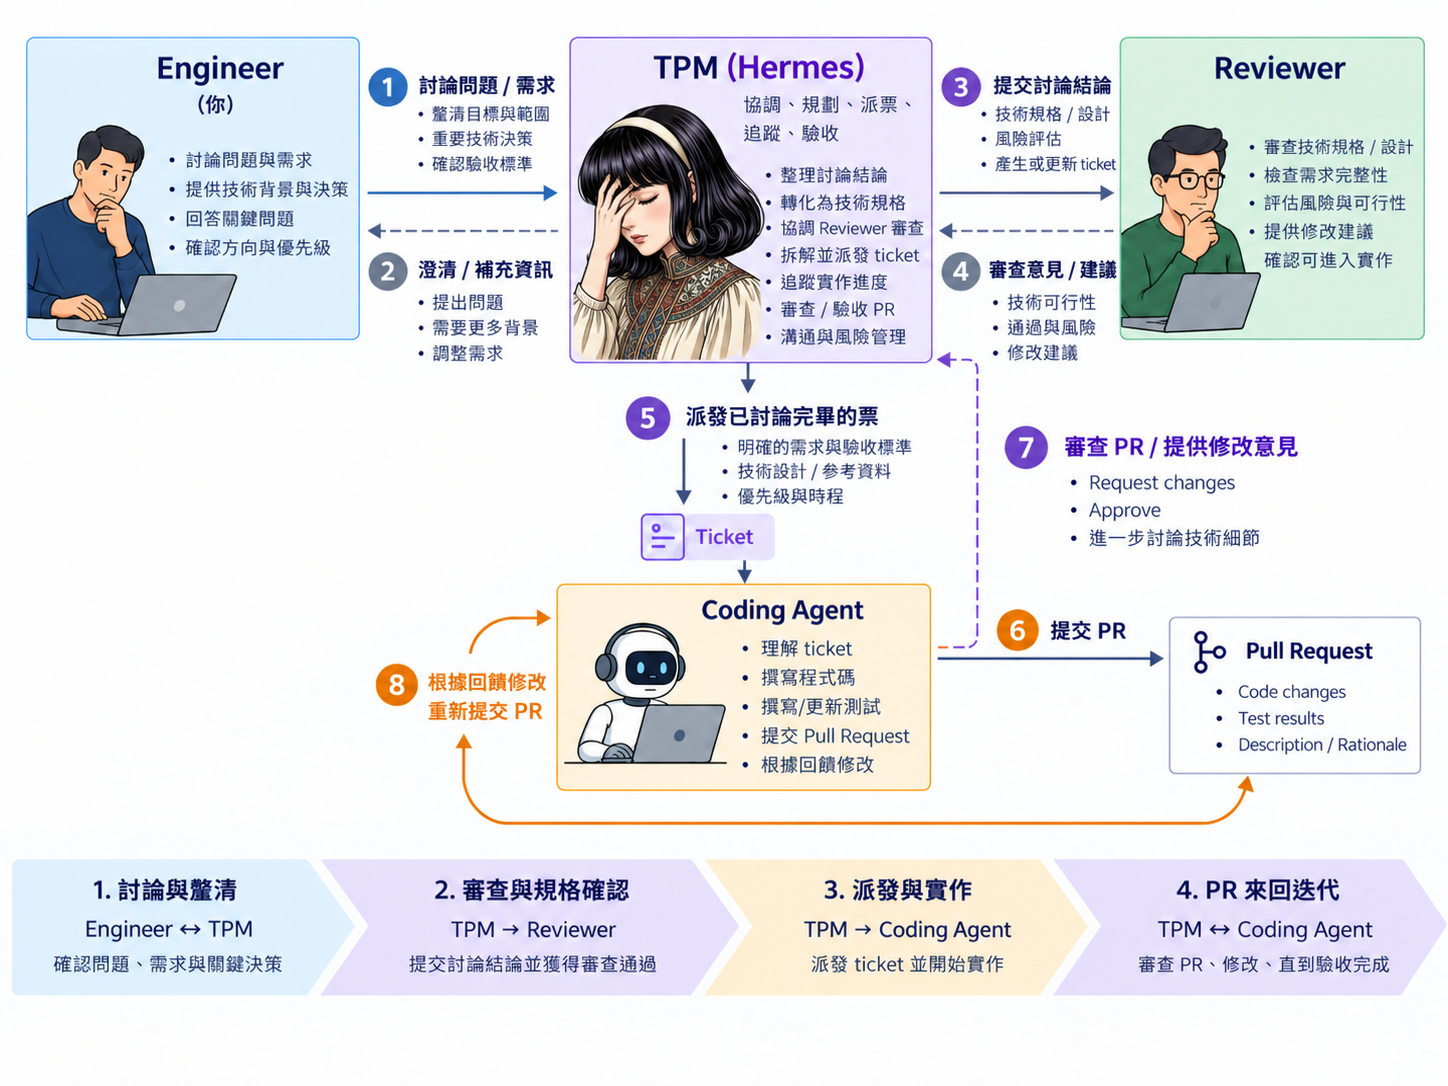
我幾乎不直接找 coding agent。無論是新功能還是修 bug,我主要都跟 Hermes 討論,由它看現有的實作、整理需求,再喚起適合的 agent 做事。這樣我不用在幾個對話之間搬背景,也不必記得哪個 agent 聽過哪一段說明。Hermes 是持續跟我對話、把工作接起來的那個角色。事實上,由於這階段人類介入頗深,通常OpenAI來講Sol 6.1就已經足夠應付了。
派工通常以一份完整的文件為單位,最常見的就是一張 ticket。這裡的 ticket 是一份工作單,記錄為什麼要做、要改什麼、哪些不在範圍內,以及怎樣才算完成。實作者拿到的不是一句「幫我加個匯出」,而是一份可以據此工作、最後也能拿來驗收的規格。Orca原生支援Linear跟Jira,不過我個人習慣使用Jetbrains YouTrack,雲端版個人使用幾乎是免費的,非常方便,只是skill要稍微費點心思搭起來就是了 — 這本來就是Hermes的專長。
假設我們開發一個匯出功能,整個spec要怎麼描述匯出哪些資料、從哪裡操作、檔案格式是什麼、資料很多時怎麼處理,都應該先在票裡講清楚。派工前會先 review 這張票,看看它是否已經足以閉環,也就是接手的人能不能照著它實作、驗證,再交回一個完整結果。還需要釐清的需求就先討論完,不能把產品決定留給實作者各自猜。這裡的 review 是檢查規格是否成熟,和後面檢查程式變更的 code review 是不同階段。
Reviewer通常就是用最貴的那顆模型來做了,以OpenAI來講就是Astra Low-Medium。
沒有相依性的票,就可以一起做
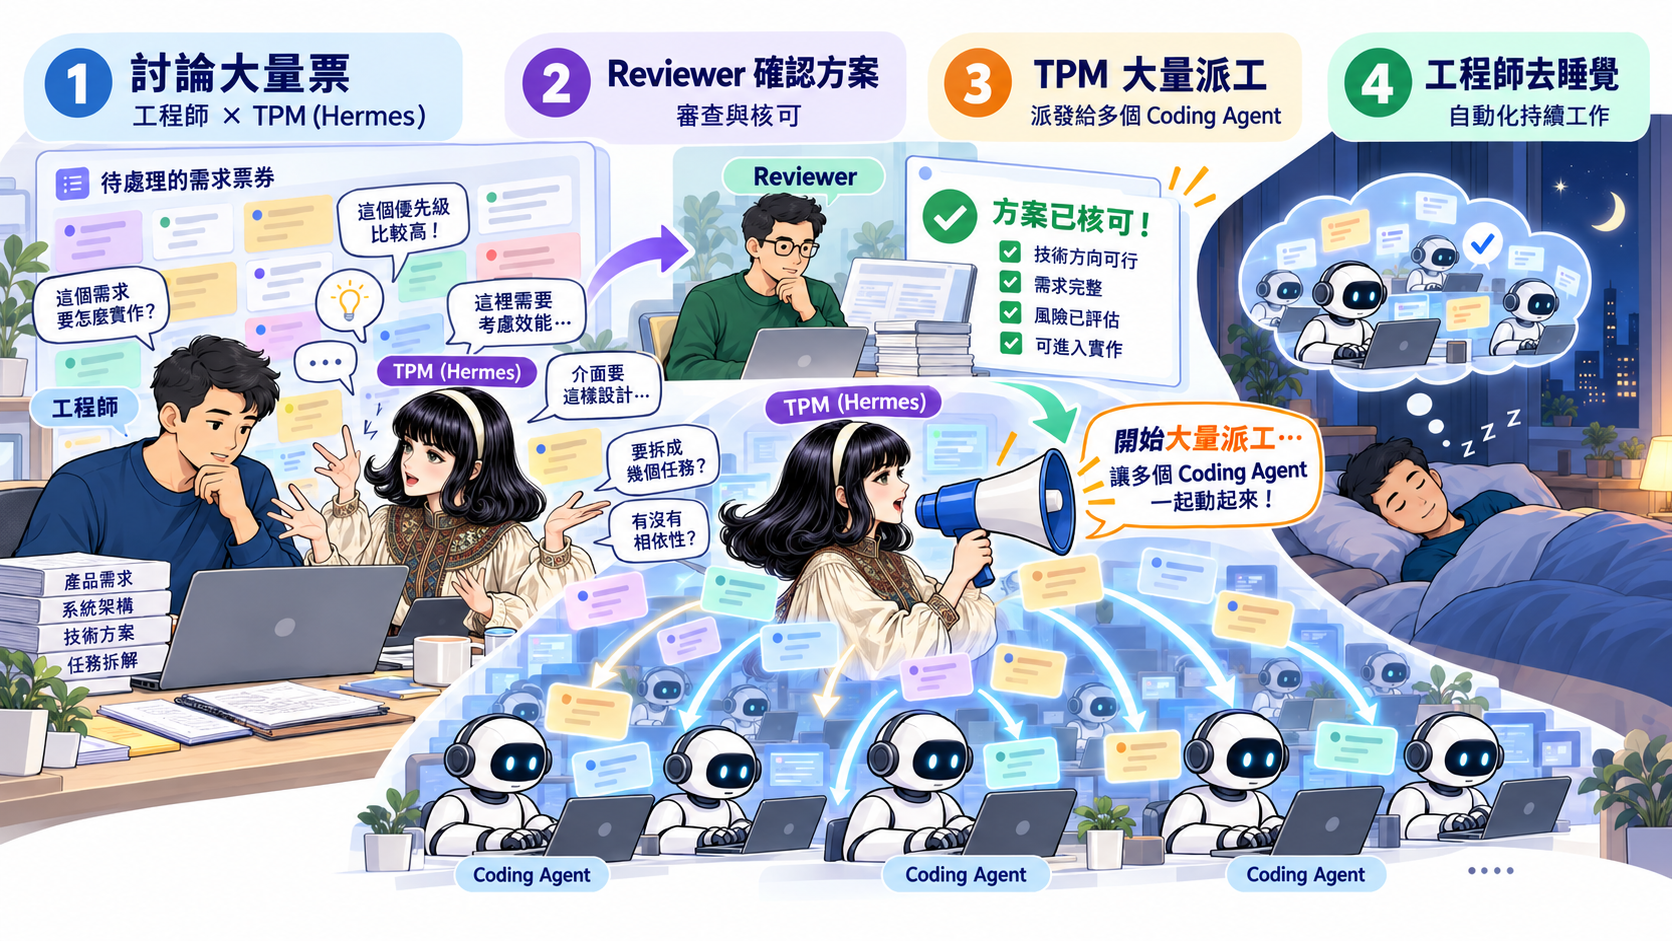
票準備好之後,Hermes 會透過 Orca 啟動 agent、交付任務,並讓派出去的 agent 在各自的 worktree 裡工作。Worktree 是 Git 的功能:同一個專案可以有幾個分開的工作目錄,各自使用不同分支。一張票的修改留在自己的目錄裡,不會直接蓋掉另一個 agent 正在改的檔案。
所以只要任務之間沒有相依性,通常就能同時派很多張票出去做,不用等前一張完成才啟動下一張。例如匯出功能和一個不相關的登入問題,規格各自清楚、也不需要等待對方的結果,就可以並行。反過來,如果前端要用的後端介面還沒定,就先處理那個依賴,不能因為開了不同 worktree,就當作兩邊已經互不影響。
開工作空間、喚起 agent、交代文件,這些都可以由 Hermes 執行,我不需要自己逐一輸入啟動指令。Orca 裡仍然看得到各個工作空間和對應的 agent,需要時也能進去查看;只是平常的派工與追蹤由 Hermes 接著做。Worktree 隔開的是工作中的檔案,最後不同分支的變更仍要整合,這部分也不能省略。
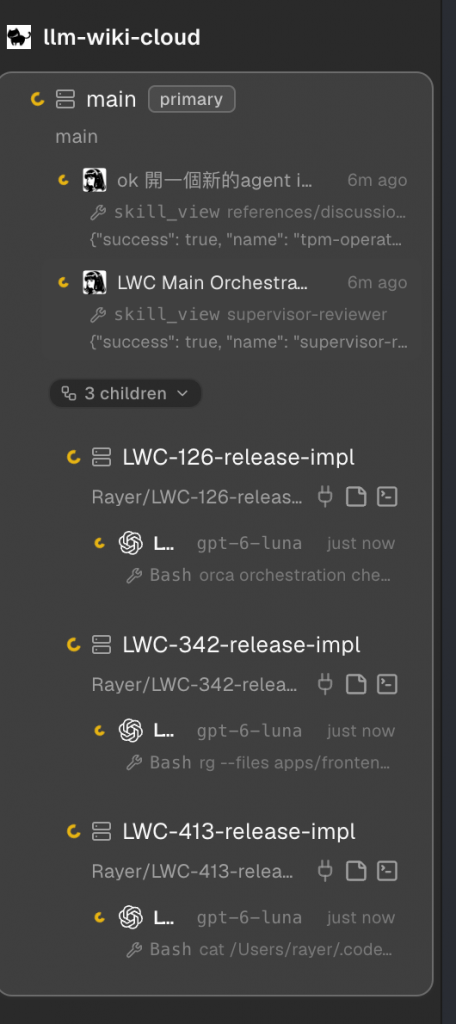
Agent 有問題,可以回來問 Hermes
派工前先把規格講清楚,不代表實作時就不會有問題。Agent 讀到實際程式後,可能發現現況與文件不同,或某個做法受到既有架構限制。這時它可以透過 Orca orchestration 回來問 Hermes,收到回答後繼續工作,不需要我在兩個對話之間複製貼上。Orchestration 就是這裡的任務協調機制。Hermes 負責派工與收集結果,接到工作的 agent 稱為 worker;worker 可以傳問題、等待回答,也可以回報完成。它們沒有共用同一份腦內記憶,所以派工文件仍然重要。回頭提問是用來處理執行中遇到的新資訊,不是拿來補一張還沒寫清楚就丟出去的票。
一般工程問題由 Hermes 先處理,需要我決定的產品取捨或範圍變動,再帶回來討論。如果答案改變了原本規格,也要寫回票裡,讓實作和後面的 review 都有同一份依據。我不用守著每個終端機等提問,但需要我做的決定仍然會回到我這裡。
做完之後,回到同一張票驗收
Agent 回報完成後,Hermes 會接回結果,配合 code review 檢查實際變更,對照原本那張票看需求有沒有做完。派工前看的,是票本身夠不夠清楚、能不能做出完整結果;實作後看的,則是程式和驗證是否真的滿足它。Review 發現問題,就回到原本的實作 agent 修正,不用每輪換人、重建背景。只有「已完成,測試通過」不太夠,回報要能指出改了哪裡、跑過哪些驗證、還有什麼沒確認。像匯出功能,除了能產生檔案,也要對照票裡約定的操作入口、等待狀態和資料內容,確認整段使用流程有接起來。程式合併、部署完成,以及我自己操作後覺得可以,是不同的進度,不能全部收在一句「完成」裡。
不是每個工作都需要最聰明的大腦
把工作派出去,還有一個好處:不必讓所有任務都用同一個模型。Harness 是讓模型做事的工具,模型才是背後負責推理的大腦,兩者不必綁死。選擇 agent 時,可以一起考慮它擅長的工具、可用的模型,以及這張票到底需要多少判斷能力。
需求還很模糊、需要跨幾個模組理解影響,或碰到難追的 bug 時,比較強的模型就有價值。但如果規格已經清楚、修改範圍固定,也有明確的測試可以驗證,就不一定每次都要用最昂貴、推理最久的選項。例如照著既定格式補上匯出欄位,和決定整個匯出功能該怎麼設計,需要的是不同程度的判斷。前面把 ticket 寫清楚,也是在減少實作者需要自行猜測的部分,讓較快、較便宜的模型有機會把工作做好。
這不表示小模型一定夠,也不是省下單次呼叫的錢就算划算。如果它反覆改錯,最後還要更強的模型重做,總成本可能更高。我比較在意的是整張票做到完成花了多少時間和費用,而不是每一步都指定最強模型。需要深入推理的地方花錢,已經有清楚做法的工作就選夠用的;最後仍然對照同一份規格驗收,不因為用了便宜模型就降低要求。不過事實證明Luna便宜但是表現相當好…
當然也可以說我預算有限,不可能一個astra或者opus打到底… 很多時候都是使用sol來討論,astra來review,至於規格完善後luna來接手把code寫出來。最貴的大腦總要花在價值最高的地方。另外,也許有人已經想到了,最貴的可能不只是模型,事實上工程師的時間才是最貴的那一塊,更需要把這個工時放在最critical的地方。
整個流程中我自己用的設定是這樣,大家可以按照自己需求來調整:
| 角色 | 模型 | 思考 | 註解 |
|---|---|---|---|
| TPM | Sol 6.1 | High | 負責協調,以及Clarify每張票的Spec |
| Reviewer | Astra | Medium | 要有整個專案的知識 |
| Coder | Luna | xHigh | 負責把spec轉成code |
| Owner | 人腦 | 懶惰 | 其實跑多了你會發現這角色不可或缺 |
要教整套流程怎麼自己變聰明
引用Tony Wu對整個機制的說明,詳細連結看這裡
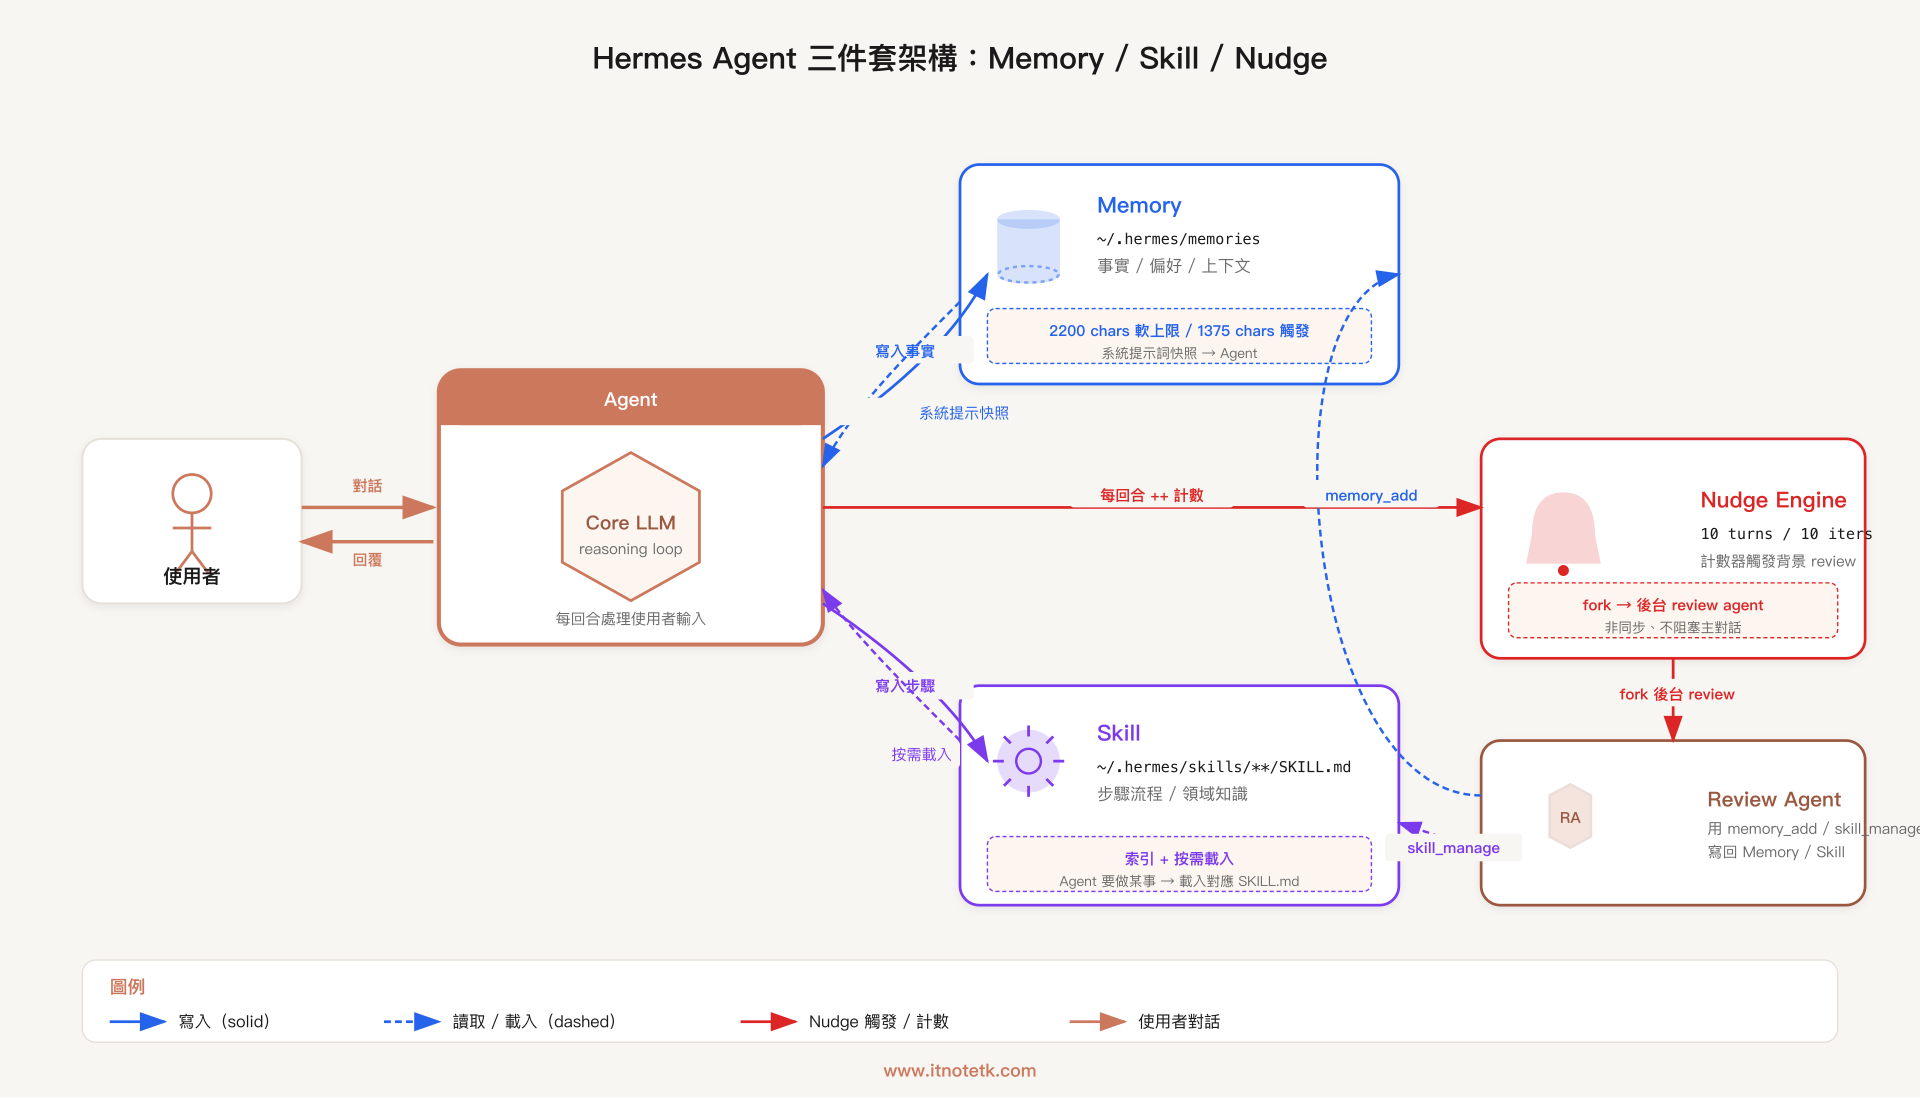
這也是我早期就採用 Hermes 最重要的理由。我不只想讓 agent 把眼前的工作做完,也希望這次花時間釐清的事情,下次不用再教一遍。如果每次開新對話都得重新解釋怎麼派工、什麼才算驗證完成,以及哪些問題不要丟回來問我,那省下的寫程式時間,很可能又花在帶 agent 上面。
Hermes 讓我可以在工作過程中逐步教它。它做錯時,除了修正這次的結果,也可以請它找出為什麼會錯,把能重複使用的做法整理成 skill,或修改既有的 skill。Skill 就是一份 agent 在需要時可以載入的操作說明,不是重新訓練模型。例如某個工具應該怎麼用、派工時要帶哪些背景、測試結果該怎麼判讀,都可以留下來。我的偏好則有另外的記憶機制,不必每次開新對話都重新說。
重點是把回饋變成下次真的會用到的改變。假設 agent 回報「測試通過」,後來才發現它只測了底層函式,沒有走過使用者按下匯出、等待、下載檔案的流程。這次當然要補測,但也可以回頭修正驗證的操作說明,讓下一次派工和 review 就知道要檢查整段流程。如果是程式容易反覆出現的錯誤,則補成自動化測試,比只多寫一句「下次小心」有用。
久了之後,改變的就不只是 Hermes 怎麼回答我,也包括它怎麼準備 ticket、把什麼資訊交給 worker、怎麼接回問題,以及最後拿什麼結果給我看。Coding agent 不必參與過前面的每次討論,只要派工時能讀到相關規格與操作說明,就能用上先前整理好的經驗。這是我說整套流程會變聰明的意思:同樣的事情,逐漸少一點重教、少一點來回,讓我可以放心交出去的範圍慢慢增加,而不是期待模型自己突然升級。
專案的記憶則有很大一部分留在 ITS 裡。一張票從討論、規格確定,到實作、review 和測試,會慢慢留下這件事的來龍去脈。例如之後想調整匯出格式,Hermes 可以先查原本的票,看看當時答應了哪些行為、為什麼選這個格式,以及哪些情境已經測過。實際程式、測試紀錄或較長的規格文件不必全部複製進票裡,但要有連結能找回去;測試結果也要看它對應哪個版本,不能把以前通過的紀錄當成現在仍然通過。
這和 skill 記住「這類事情怎麼做」不太一樣,ITS 留下的是「這個專案當時做了什麼、為什麼這樣做」。需求改變時,也要更新目前適用的規格,讓接手的 agent 分得清楚哪些是舊決定、哪些才是這次的要求。我不想每遇到一次問題,就永久加一大段規則;有些問題加一個測試就能解決,有些只是這次的情境,留在對應的票裡就好。寫下來也不保證它已經學會,還要看下一次遇到同類工作時,是否真的找得到、用得上;不適用的說明就得修掉,否則只是把舊錯誤存得更久。
拿一些古聖先賢(?)的文章跟Hermes討論
除了自己踩坑,我也會把別人的文章丟給 Hermes,一起看有哪些做法值得借來用。但我通常不只問「幫我摘要」,而是請它對照現在的 workflow:哪些已經有了、哪些根本沒做到、哪些看似合理,其實不適合我們。讀完別人的經驗,不需要立刻替自己加一套流程,更不需要把作者的每個建議都變成新規定。
最近就有一個例子。我讀了 Matt Pocock 原始貼文。裡面提到 skill 太長、全域指示塞太多,以及人花太多時間盯 agent。我們沒有停在「有道理」,而是讓 Hermes 看自己的工作環境。結果光是協調工作的那份 skill,就已經長到接近一百 KB:為了讓它不要重犯錯,我們不斷補充教訓,最後連不相關的工作也得先讀進一大堆內容。這篇文章我看到以後就跟agent討論,看我們有沒有類似的問題。討論後收穫是巨大的,本來我們每次工作都要讀一個很長的文件當SSOT,造成context量飆升,後來我們把整個SSOT normalize成一個標準化的skill,把常用原則留在短入口,個別主題的操作說明等需要時再讀;歷史進度和原始證據則保留在各自的位置,不再全部塞進每次開工都要讀的文件。這樣沒有把過去的經驗丟掉,只是改成先知道去哪裡找,再讀這次需要的部分。藉由conditional routing,讓我們整個context用量降低了至少一個數量級,增益巨大。
另一個討論是從 Anthropic 分享的 code review 做法 延伸出來的。Agent 寫程式很快,review 卻可能一輪接一輪:每次再找出一點問題,每次再修一點,大家都很忙,票就是交不出去。這讓我們重新檢查複審該看什麼、同一類問題能不能一次修完,以及已經有結論的事情為什麼又被拿回來談。不是少做檢查就算改善,也不是 review 次數越多就越可靠,而是要讓檢查能把工作帶到完成。
聊到人工 review 時,我還發現一個更直接的問題:我根本不太知道哪些 PR 需要我看。對我來說,重點不是替 agent 訂一套 coding style,而是它什麼時候需要我判斷產品、什麼時候有可操作的東西要我體驗。所以我們把交付說明補清楚:這次需不需要我看?需要的話,看哪裡、要決定什麼?不需要的就留在摘要,不必每次開 PR 都叫我進場。這類討論最後會回到 Hermes 的操作說明,影響下一次怎麼派工、review 和交付。對我而言,這比收藏一堆文章有用:拿別人的經驗找出自己的問題,討論完,讓工作方式真的跟著改一點。
最後
如果只是要在遠端機器跑一個長時間任務,tmux 依然很適合,沒有必要為此換掉它。然而,Orca不但提供了tmux所有功能,也解決了工作會跨過好幾段對話的問題:從一個還沒成形的想法,到實作、review,再到我能打開來用的結果。中間需要有人記得前面說過什麼,也需要一個找得回各項工作的地方。現在這套用法還在調整。有時候值得多開一個 agent,有時候自己直接把事情做完比較省事。最後也能找到一個方法,讓工程師的時間能充分用在該用的地方,而有些東西其實是可以直接放手讓agent去做的。剛說到model routing,其實工程師才是整套系統裡面最貴的一個,所以應該要把effort放在更正確的地方才對。
—
本文受 crystl 的 〈tmux for AI Coding Agents〉 啟發,記錄我使用 Hermes 與 Orca 的方式。工具行為可能隨版本調整;Orca 的 CLI 用法可透過執行檔提供的 orca skills get orca-cli --json 與 orca skills get orchestration --json 查閱,Hermes 則以官方文件為準。